從「大量投遞」到「精準配對」:AI 協助求職的效率陷阱、履歷品質與人機協作框架
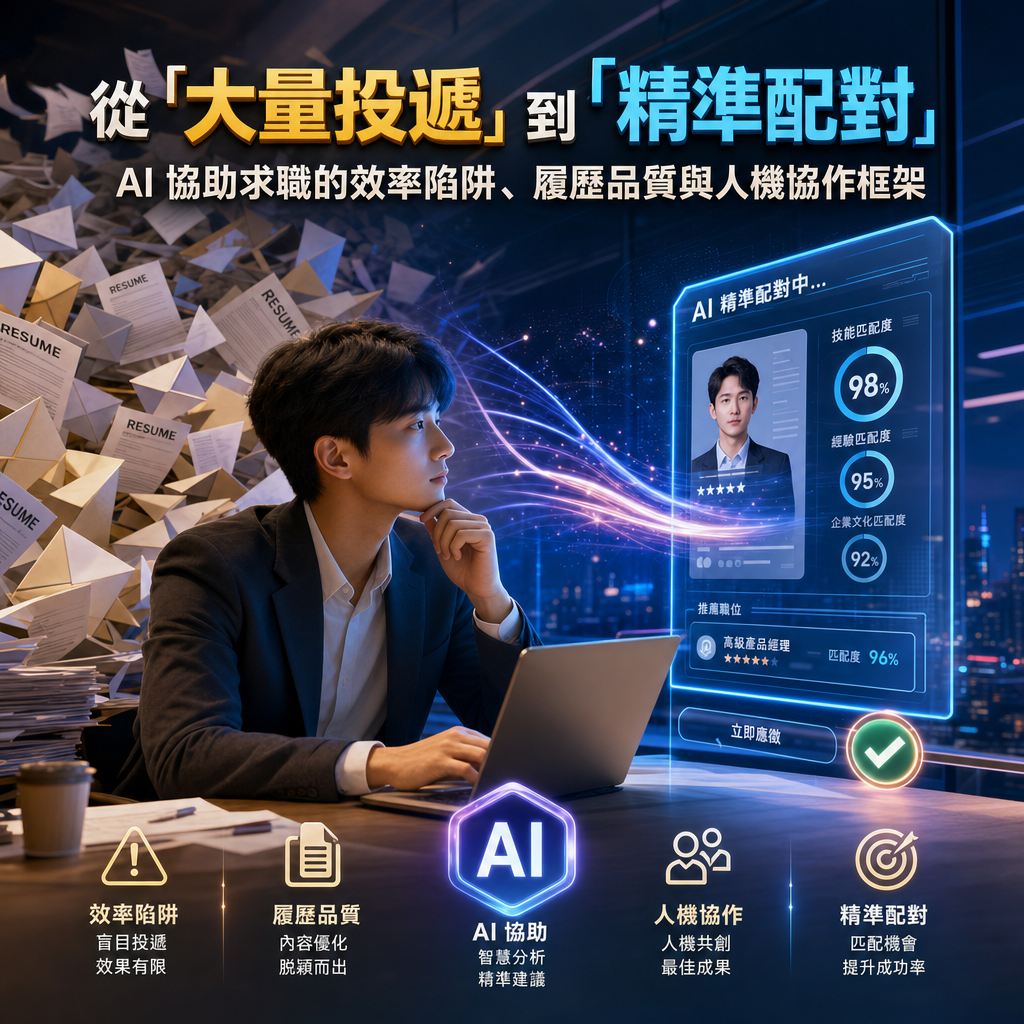
「我申請了 200 份工作」聽起來像是一種積極的求職策略,但實際結果未必理想。Yahoo 新聞的相關報導聚焦於一個核心問題:當求職者把 AI 當成大量製作履歷與自薦信的工具,表面上增加了投遞數量,卻可能同時降低每一份履歷的辨識度與可信度。
AI 確實可以協助求職者整理經歷、調整語句、分析職缺與進行模擬面試;問題不在於使用 AI,而在於是否理解「求職」本質上是一場需要高度客製化與可信度驗證的雙向溝通。當履歷從「針對某個職缺提出具體證據」變成「同一份內容寄給數百家企業」,投遞行為就可能從有效行銷退化為無差別資訊轟炸。
因此,現代求職者真正需要的不是更快的投遞速度,而是建立一套能夠同時提升「匹配精準度、內容可信度與決策回饋速度」的人機協作流程。
一、為什麼 AI「撒網式投履歷」容易弄巧成拙?
首先,必須釐清一項常見誤解:申請數量多,不代表轉換機率必然提高。求職可視為一個漏斗流程,其中至少包含投遞、初步回覆、邀約面試、錄取等不同階段。如果大量投遞之後沒有回覆,問題可能出在履歷呈現、職缺定位、關鍵字匹配或投遞管道;如果有回覆卻沒有面試機會,則可能與自薦信、證據能力或面試表現有關;若能進入面試卻未錄取,則需要進一步檢討專業技能與面試準備。
盲目增加投遞量,會讓求職者無法判斷瓶頸究竟位於哪個環節,也會消耗大量時間並削弱準備面試的精力。
- 同質化履歷降低辨識度:如果大量履歷使用相同段落,招募人員很難看出求職者為何適合該職缺。大量寄送相同內容,不僅浪費企業資源,也可能讓求職者被判定為缺乏準備。
- 關鍵字堆砌破壞可讀性:部分求職者會要求 AI 將職缺中的所有關鍵字塞入履歷。然而,現代招募系統並非只做字串比對;招募人員也會觀察語意、成果與能力證據。過度堆砌反而可能讓履歷失去專業感。
- AI 生成內容可能偏離事實:模型有時會擅自補上不存在的專案、職稱、成果數字或技術能力。若求職者未逐項查核,履歷中的漂亮敘事就可能在面試或背景調查時被拆穿。
- 忽略職缺差異會造成錯誤期待:同一職稱在不同企業,可能分別重視數據分析、客戶開發、團隊管理或系統導入。若只替換公司名稱,而沒有調整能力證據與工作方法,便難以真正回應職缺需求。
- 大量投遞形成負面回饋:重複而缺乏針對性的內容可能降低回覆率。若求職者又把回覆率低歸因於「市場不適合」,便會停止修正履歷,持續重複相同策略。
二、AI 適合協助哪些工作?又應避開哪些底線?
AI 在求職流程中最有價值的用途,並非取代求職者思考,而是協助求職者處理大量重複且需要初步整理的工作。舉例而言,AI 可以將職缺描述拆解成「主要任務、必要能力、成果期待與限制條件」,也可以協助比較既有履歷與職缺需求,找出缺失證據。
在修改履歷時,AI 能夠將零散的工作紀錄改寫為清楚的就業情境,並圍繞特定職缺重新安排重點。面試準備階段,則可讓 AI 扮演不同角色的提問者,協助求職者練習回答、追問與壓力測試。此外,求職者還能利用 AI 檢查敘事是否前後一致,以及履歷中是否出現語意模糊、語氣冗長或能力與職缺無關等問題。
相對地,以下行為應被視為求職使用 AI 的底線:不可虛構工作經歷、學歷、證照、專案成果或數據;不可讓 AI 猜測應徵者過去「可能做過什麼」;不可把模型產出的內容未經查核就直接寄送;也不應將履歷中的公司機密、客戶資料或未公開專案內容,直接交由外部工具處理。
簡言之,AI 可以協助「組織語言」,但不能替求職者「創造真實」。求職者必須對每一句敘述、每一項數字與每一種技能宣稱負責。
三、建立六步驟求職工作流程,讓 AI 成為加速器而非決策者
要將 AI 有效整合至求職流程,可採用「定位、拆解、生成、查核、微調、追蹤」六個步驟。這個框架的重點不是追求完全自動化,而是將人的判斷力放在每一個關鍵節點。
步驟一:定義目標職缺,而不是先製作履歷
開始使用 AI 之前,求職者應先完成職缺定位。可以建立一張「目標職位矩陣」,記錄不同職稱所對應的核心任務與能力要求。
- 目標職稱:例如產品經理、資料分析師、客戶成功專員。
- 核心任務:該職位每天實際要解決什麼問題。
- 必要能力:哪些技能是基本門檻,哪些能力能形成競爭優勢。
- 成果指標:企業通常希望新人改善營收、效率、品質或客戶體驗。
- 個人證據:過去經歷中哪些案例可以支持上述能力。
- 待補強項目:哪些能力目前缺乏證據,需要安排學習或實作。
這項步驟能避免最常見的錯誤:花大量時間美化一份通用履歷,卻不清楚它要投遞到哪一類職缺。
步驟二:拆解職缺內容,找出真正的需求
將完整職缺描述交由 AI 分析時,不應只要求「幫我列出關鍵字」,而應要求模型比較「表面要求」與「實際工作重點」。例如,分析模型需要使用哪些工具、經驗、知識與人格特質,並進一步判斷哪些條件是必要條件,哪些只是加分條件。
分析完成後,求職者仍需回到原職缺核對。AI 可能把企業的偏好誤判為普遍規則,也可能忽略招募負責人真正關心的資訊,因此模型輸出應作為假設,而不是直接採用的結論。
步驟三:以真實資料生成履歷架構
生成前應先提供完整且正確的職涯資料,包括真實工作經歷、專案內容、职责、成果、工具與技能。較好的提示指令不是「請寫一份很厲害的履歷」,而是「請僅根據以下事實,針對目標職缺重新安排履歷順序,缺少證據的地方請標記為待確認,不得新增任何經歷」。
這種提示方式能降低 AI 補寫內容的風險,也能讓履歷保留求職者原有的判斷與表達風格。求職者可再要求模型提供兩種不同版本,例如「技術成果导向」與「商業價值导向」,再依職缺特性選擇較合適者。
步驟四:進行事實查核與品質驗證
每一份 AI 協助生成的履歷,都應至少通過三種檢查。
- 事實檢查:確認職稱、任職期間、公司名稱、專案規模、數字與技能均屬實,且能夠在面試中說明。
- 職務檢查:確認每一項能力都與目標職缺有關,並檢查是否把參與過的工作誤寫成完全負責的成果。
- 表達檢查:確認句子清楚、版式易讀、沒有空泛形容詞,也沒有為了關鍵字而破壞正常語意。
最可靠的查核方式,是逐句對照原始紀錄,並準備各項成果的證明。AI 能降低整理時間,卻無法取代當事人的記憶與責任。
步驟五:為高價值職缺進行人工微調
並非所有職缺都值得投入相同時間。求職者可依照職位重要性、薪资市場、履歷符合程度與企業互動程度進行分級。對高度符合且具有吸引力的職缺,應投入較多時間進行客製化;對明顯不符的職缺,則可快速略過。
客製化不應只更換公司名稱。真正有效的微調包含四個層次:調整履歷開頭的定位、選擇最相關的經歷、補充能證明核心能力的成果,以及讓自薦信清楚回答「為什麼是這家公司」。
步驟六:追蹤數據,利用回饋改善下一輪策略
求職者應建立簡單的投遞紀錄表,除了職缺名稱與公司名稱,還要記錄投遞日期、職缺來源、履歷版本、是否附上自薦信、回覆日期、面邀結果及最終結果。
追蹤的目的不是只計算投遞總數,而是辨識哪一類職缺、哪一种履歷版本及哪種自薦信結構能帶來較佳回應。若某次轉換有成效,還應進一步分析原因,才能將偶然成果轉化為可重複的方法。
四、從招募系統與企業觀點理解 AI 履歷的真正風險
許多求職者會特別關注求職系統篩選,也就是常稱的 ATS。對格式與內容的處理方式了解,有助於提高履歷被正確解析的機會。常見建議包括使用清楚且標準化的段落標題、保持履歷結構單純、確認關鍵技能以自然方式呈現,以及避免將核心資訊放在圖片、複雜表格或難以解析的設計元素中。
但求職者也不必陷入「只要塞入關鍵字就能通過」的迷思。企業招募並非只依賴單一工具;人員仍會閱讀履歷、檢核經驗、進行提問,並判斷候選人是否符合團隊與組織需求。履歷的首要目標不是欺騙系統,而是讓系統與人員都能正確理解求職者的價值。
從企業端來看,大量相似的 AI 履歷會增加篩選成本。當一封自薦信沒有提到企業的產品、服務或挑戰,即使文字流暢、格式完美,也可能因為缺乏相关性而被快速略過。因此,AI 提升的是產出速度;真正決定價值的仍是情境理解、證據品質與表達可信度。
五、將 AI 素養帶入職場:真正的專業能力是驗證與責任
這起議題不只關乎求職技巧,也反映 AI 時代的教育責任。學生如果只學會「生成一份履歷」,卻沒有學習查核、比較、判斷與修正,便容易把語言能力誤認為專業能力。
在課堂或職涯訓練中,可以將 AI 求職任務設計成一份「可驗證的專業作品」。例如,請學生先完成職缺研究,再建立能力與經歷的對照表,接著使用 AI 產生兩種版本,最後由學生逐項標示 AI 的建議、錯誤與修改理由。評分時不只看履歷是否漂亮,也要看資料是否準確、論證是否成立,以及求職者能否說清楚每一個選擇。
這套教學理念可以濃縮成四個能力:定義問題、理解脈絡、驗證輸出、承擔責任。未來無論從事行銷、設計、資料、工程或管理,能夠可靠地運用 AI 完成工作的人,不會只是輸入提示詞的人,而是能夠質疑結果、整合證據並對成果負責的人。
結語:求職的關鍵不是數量,而是可信的匹配
「申請 200 份工作」並非永遠錯;它可能是求職者快速探索市場的暫時策略。問題在於,若求職者沒有分析回饋、沒有客製化內容,也沒有查核 AI 生成內容,那麼大量投遞只是重複動作,而不是有效策略。
AI 最適合協助求職者整理複雜資料、增加準備速度與提供不同思考角度,但職涯定位、經驗取捨、能力證明與人際溝通,仍必須由人負責。真正有效的求職流程,不是讓 AI 替你製造數百份相似的履歷,而是讓自己更快找到值得投入的職缺,並以真實、具體、可驗證的內容證明價值。